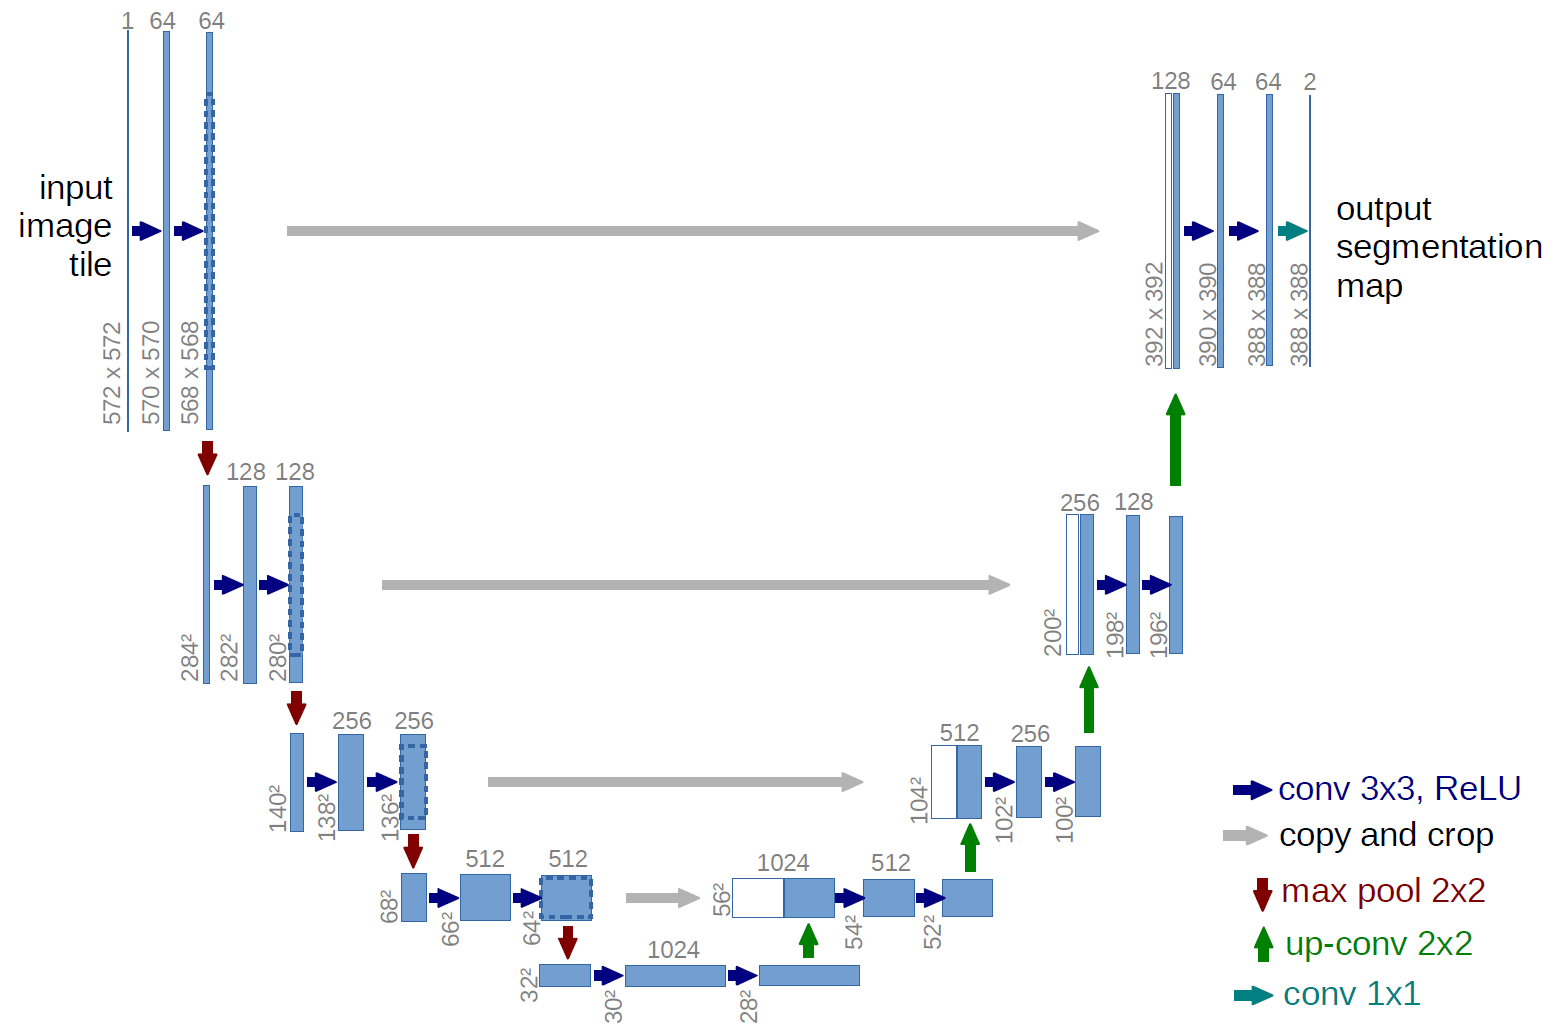
Chuỗi U-Net — Bài 4. Ba bài trước tập trung vào kiến trúc, kích thước tensor và receptive field. Bài này chuyển sang một câu hỏi khó hơn: làm thế nào biến U-Net thành một hệ thống phân đoạn thực sự có thể huấn luyện, đánh giá và phân tích lỗi?
Bài toán cụ thể được chọn là phân đoạn cấu trúc thần kinh trên ảnh hiển vi điện tử truyền qua nối tiếp (serial section Transmission Electron Microscopy — ssTEM), gần với bài toán benchmark mà U-Net gốc được đánh giá. Đây là ví dụ phù hợp để thấy rằng chất lượng segmentation không chỉ phụ thuộc kiến trúc mạng mà còn phụ thuộc mạnh vào định nghĩa nhãn, loss, cách chia dữ liệu, augmentation và metric.
- Xây dựng pipeline U-Net cho dữ liệu ssTEM gồm ảnh grayscale và binary mask ở mức pixel.
- Phân tích tại sao binary cross-entropy và Dice loss tối ưu hai khía cạnh khác nhau, và vì sao kết hợp chúng thường là một baseline hợp lý.
- Augmentation hình học phải tác động đồng bộ lên ảnh và mask; interpolation của mask phải giữ nguyên nhãn rời rạc.
- Dice hoặc IoU cao chưa chắc bảo toàn topology: một lỗi nhỏ trên màng mỏng có thể làm hai cấu trúc thần kinh bị nối thành một vùng.
1. Bài toán: từ ảnh ssTEM đến bản đồ phân đoạn
ISBI 2012 tổ chức một challenge về phân đoạn cấu trúc thần kinh trong các stack ảnh hiển vi điện tử. Tập training được mô tả gồm 30 lát cắt ssTEM từ ventral nerve cord của ấu trùng Drosophila; nhãn được cung cấp dưới dạng binary segmentation. Đây cũng là benchmark được U-Net sử dụng trong công trình năm 2015. :contentReference[oaicite:0]{index=0}
Dữ liệu kiểu này khác đáng kể ảnh tự nhiên. Ảnh chỉ có một kênh cường độ, cấu trúc cần phân đoạn có hình dạng phức tạp và các màng ngăn cách hai vùng có thể rất mỏng. Một sai số chỉ vài pixel tại màng có khả năng làm hai cấu trúc vốn tách biệt trở thành một thành phần liên thông duy nhất.
Có thể biểu diễn bài toán binary segmentation bằng ánh xạ:
Đầu vào x là ảnh grayscale, còn U-Net sinh một logit zi cho mỗi pixel i. Xác suất foreground được tính bằng sigmoid:
Trong PyTorch, nên để model trả về logits thay vì gọi sigmoid ngay trong forward. Các loss như BCEWithLogitsLoss kết hợp sigmoid và binary cross-entropy theo dạng số học ổn định hơn.
2. Pipeline huấn luyện: phần khó không nằm riêng ở U-Net
Một pipeline segmentation hợp lý cần giữ rõ ranh giới giữa dữ liệu gốc, biến đổi dùng trong training, đầu ra xác suất và mask sau threshold. Trộn các bước này với nhau thường dẫn đến lỗi khó phát hiện, đặc biệt khi augmentation làm sai mask hoặc metric được tính trực tiếp trên logits.
Đặc biệt với serial sections, việc chia dữ liệu cũng cần thận trọng. Hai lát cắt liên tiếp có thể rất giống nhau về cấu trúc giải phẫu. Nếu lấy slice 10 làm training và slice 11 làm validation, kết quả validation có thể lạc quan hơn khả năng tổng quát hóa thực sự.
Challenge ISBI cung cấp training và test từ các volume riêng biệt, phản ánh đúng hơn cách đánh giá thuật toán trên dữ liệu chưa thấy. :contentReference[oaicite:2]{index=2}
3. Loss: pixel đúng chưa chắc cấu trúc đúng
Binary cross-entropy
Với ground truth yi ∈ {0,1} và xác suất dự đoán pi, binary cross-entropy trên N pixel là:
BCE xem mỗi pixel như một quyết định nhị phân. Điều này tạo gradient rõ ở mức pixel nhưng không trực tiếp tối ưu độ chồng lấp của toàn bộ vùng segmentation.
U-Net gốc thực tế không sử dụng Dice loss. Ronneberger và cộng sự sử dụng pixel-wise softmax kết hợp weighted cross-entropy, trong đó weight map được thiết kế để tăng mức phạt ở vùng biên giữa các đối tượng chạm nhau [1]. :contentReference[oaicite:3]{index=3}
Soft Dice loss
Dice coefficient cho binary segmentation có thể viết dưới dạng:
Để dùng trong backpropagation, prediction nhị phân được thay bằng xác suất mềm p:
Loss tương ứng là:
Một objective dựa trên Dice được Milletari, Navab và Ahmadi sử dụng trong V-Net nhằm xử lý các tình huống có mất cân bằng mạnh giữa foreground và background [3]. :contentReference[oaicite:4]{index=4}
Tại sao kết hợp BCE và Dice?
Một baseline thực dụng là:
BCE duy trì supervision tại từng pixel, còn Dice quan tâm trực tiếp hơn đến độ chồng lấp của toàn vùng. Giá trị λ không có một lựa chọn tối ưu cho mọi dataset; λ = 0.5 chỉ nên coi là điểm bắt đầu để thực nghiệm, không phải một hằng số chuẩn.
4. Chuẩn bị dữ liệu đúng: augmentation phải đồng bộ ảnh và mask
U-Net gốc nhấn mạnh data augmentation để khai thác hiệu quả số lượng ảnh gán nhãn hạn chế, bao gồm cả các biến dạng đàn hồi nhằm mô phỏng biến thiên hình học trong ảnh hiển vi [1]. :contentReference[oaicite:5]{index=5}
Trong một baseline hiện đại, có thể bắt đầu bằng flip và xoay 90°. Điều quan trọng là mọi biến đổi hình học phải áp dụng chính xác cùng tham số cho image và mask. Ngược lại, biến đổi cường độ như brightness, contrast hoặc noise chỉ tác động lên ảnh.
Giả sử dữ liệu được tổ chức thành hai thư mục images/ và masks/, đoạn mã sau tạo dataset cho ảnh grayscale:
Việc dùng xoay theo bội số 90° ở đây có một lợi ích thực dụng: không cần interpolation nên cả ảnh và mask giữ được lưới pixel chính xác. Với elastic deformation như U-Net gốc, pipeline phải xử lý interpolation của image và mask riêng biệt.
5. Cài đặt BCE–Dice loss và metric đúng cách
Đoạn code sau tính loss trên xác suất mềm nhưng tính metric trên mask đã threshold. Hai bước này không nên nhầm lẫn.
Dice và Intersection over Union (IoU) đều đo overlap. Với cùng một binary mask:
và hai metric liên hệ bởi:
Do đó Dice và IoU không phải hai góc nhìn hoàn toàn độc lập về cùng một binary segmentation. Nếu cần phân tích sâu hơn, nên bổ sung metric về boundary, precision/recall hoặc topology thay vì chỉ báo cáo thêm nhiều biến thể của overlap.
Threshold 0.5 không phải định luật
Sigmoid tạo xác suất trong khoảng 0–1, nhưng việc chọn 0.5 để chuyển sang binary mask chỉ là mặc định phổ biến. Nếu validation cho thấy threshold 0.42 tạo trade-off tốt hơn giữa false positive và false negative, có thể dùng 0.42.
Threshold phải được chọn trên validation set. Tìm threshold tối ưu trực tiếp trên test set làm rò rỉ thông tin test vào quá trình thiết kế mô hình và khiến kết quả cuối không còn là đánh giá độc lập.
6. Training loop và cách đọc kết quả
Giả sử class UNet đã được xây dựng như ở Bài 1, với một input channel và một output channel. Training loop cơ bản có thể viết như sau:
Các giá trị learning rate, số epoch hoặc weight decay trong ví dụ trên chỉ là cấu hình khởi đầu. Không nên biến chúng thành “tham số chuẩn của U-Net”. Learning rate cần được kiểm tra qua validation; số epoch nên kết hợp early stopping hoặc lưu checkpoint tốt nhất thay vì mặc định model ở epoch cuối là model tốt nhất.
Đọc learning curve như một thí nghiệm
| Hiện tượng | Khả năng xảy ra | Kiểm tra tiếp theo |
|---|---|---|
| Train loss giảm, validation Dice giảm | Overfitting | Augmentation, regularization, early stopping, kiểm tra split |
| Loss gần như không giảm | Learning rate, normalization hoặc bug dữ liệu | Overfit thử 1–2 ảnh trước |
| Dice cao nhưng nhiều vùng bị merge | Metric vùng bỏ qua lỗi topology nhỏ | Kiểm tra boundary/topology metric và visualization |
| Prediction toàn foreground hoặc background | Class imbalance, label sai hoặc loss sai | Kiểm tra phân bố mask, sigmoid và mapping nhãn |
Một test rất hiệu quả trước khi huấn luyện toàn bộ dữ liệu là yêu cầu model overfit một hoặc hai ảnh. Nếu U-Net đủ năng lực nhưng không thể học gần khớp một mẫu nhỏ, thường có lỗi ở preprocessing, mask, loss, shape hoặc optimizer. Đây là phép kiểm tra pipeline, không phải phép đánh giá khả năng tổng quát hóa.
7. Dice cao vẫn có thể là segmentation kém
Đây là phần quan trọng nhất khi chuyển từ một bài demo sang một thí nghiệm có ý nghĩa. Giả sử ground truth chứa hai vùng thần kinh tách nhau bởi một màng chỉ rộng ba pixel. Mô hình dự đoán đúng gần như toàn bộ diện tích nhưng làm mất một đoạn màng dài 15 pixel.
Số pixel sai có thể rất nhỏ so với toàn ảnh, vì vậy Dice và IoU chỉ giảm nhẹ. Tuy nhiên sau connected-component analysis, hai vùng đã merge thành một đối tượng. Với bài toán phân tích cấu trúc thần kinh, lỗi đó có thể nghiêm trọng hơn hàng trăm pixel sai nằm sâu bên trong một vùng.
Chính vì lý do này, challenge ISBI 2012 không chỉ quan tâm pixel classification mà còn sử dụng các metric nhấn mạnh lỗi segmentation và topology, bao gồm warping error và foreground-restricted Rand measure. :contentReference[oaicite:6]{index=6}
Điều này dẫn tới một nguyên tắc quan trọng:
Nếu mục tiêu chỉ là diện tích vùng, Dice có thể phù hợp. Nếu biên, connectivity hoặc số lượng đối tượng quan trọng, cần thêm boundary hoặc topology-aware evaluation.
Paper U-Net gốc cũng nhận ra vấn đề tách các đối tượng chạm nhau và thiết kế weight map cho cross-entropy để tăng trọng số tại vùng biên giữa hai đối tượng [1]. Đây không phải chi tiết phụ: nó cho thấy loss function nên được thiết kế dựa trên loại lỗi của bài toán chứ không chỉ dựa trên sự tiện lợi khi cài đặt. :contentReference[oaicite:7]{index=7}
Weighted loss của U-Net gốc
Weight map được paper định nghĩa theo khoảng cách đến biên của hai đối tượng gần nhất:
Trong đó d1(x) là khoảng cách từ pixel x đến biên của đối tượng gần nhất và d2(x) là khoảng cách đến biên của đối tượng gần thứ hai. Khi pixel nằm ở khe hẹp giữa hai đối tượng, cả hai khoảng cách đều nhỏ nên exponential term lớn và lỗi tại đó được phạt mạnh hơn.
Đây là ví dụ điển hình cho việc đưa prior về hình học của bài toán vào objective. Dice loss xử lý overlap; weighted cross-entropy có thể nhấn mạnh vùng biên; Tversky loss cho phép điều chỉnh bất đối xứng giữa false positive và false negative trong các bài toán mất cân bằng mạnh [4]. :contentReference[oaicite:8]{index=8}
8. Một protocol thực nghiệm đáng tin cậy hơn
Nếu mục tiêu là làm nghiên cứu thay vì chỉ chạy được model, nên cố định protocol trước khi tuning. Một cấu hình hợp lý cho bài toán này có thể gồm:
- Input: ảnh grayscale, normalize bằng thống kê train hoặc một quy tắc cố định.
- Split: tách theo volume/specimen khi có thể; không để các patch từ cùng ảnh xuất hiện đồng thời ở train và validation.
- Baseline: U-Net thuần với cùng preprocessing trước khi thử Attention U-Net, U-Net++ hoặc Transformer.
- Loss: BCE, Dice và BCE+Dice như ba experiment riêng thay vì chọn loss tốt nhất rồi chỉ báo cáo nó.
- Metric: Dice/IoU cho overlap, thêm metric phù hợp topology hoặc boundary nếu bài toán quan tâm connectivity.
- Threshold: chọn trên validation, sau đó khóa threshold trước test.
- Qualitative analysis: hiển thị input, ground truth, probability map và binary prediction cho cả ca tốt lẫn ca thất bại.
Một ablation nhỏ nhưng có giá trị hơn việc thay đổi hàng loạt thành phần cùng lúc:
| Experiment | Loss | Augmentation | Mục đích |
|---|---|---|---|
| E1 | BCE | Không | Baseline tối thiểu |
| E2 | BCE + Dice | Không | Ảnh hưởng của loss |
| E3 | BCE + Dice | Flip + rotate | Ảnh hưởng augmentation |
| E4 | Boundary-weighted | Flip + rotate | Kiểm tra lỗi biên/topology |
Không nên điền sẵn các con số “kỳ vọng” vào bảng trước khi chạy thí nghiệm. Giá trị của ablation nằm ở việc giữ các thành phần khác cố định để xác định thay đổi nào thực sự tạo ra khác biệt.
9. Kết luận
Trong một bài toán thực tế, U-Net chỉ là một thành phần của hệ thống segmentation. Quyết định nhãn nào là foreground, chia dữ liệu ra sao, augmentation có bảo toàn mask hay không, loss tối ưu loại lỗi gì và metric đo điều gì đều có thể ảnh hưởng đến kết luận nhiều không kém việc thay đổi kiến trúc.
Với ảnh hiển vi điện tử, BCE–Dice là baseline tốt để bắt đầu nhưng chưa chắc là objective cuối cùng. Khi các màng mỏng quyết định connectivity của cấu trúc, cần nhìn xa hơn overlap và phân tích trực tiếp boundary cũng như topology.
Đây cũng là bước chuyển quan trọng từ việc “dùng U-Net” sang thiết kế một thí nghiệm segmentation có thể bảo vệ về mặt khoa học. Bài tiếp theo có thể đi sâu vào Dice Loss, Focal Loss, Tversky Loss và Boundary Loss, phân tích gradient và chỉ rõ từng loss phù hợp với dạng mất cân bằng nào.
Tài liệu tham khảo
[1] O. Ronneberger, P. Fischer, and T. Brox, “U-Net: Convolutional Networks for Biomedical Image Segmentation,” in Medical Image Computing and Computer-Assisted Intervention – MICCAI 2015, Lecture Notes in Computer Science, vol. 9351, Munich, Germany, 2015, pp. 234–241, doi: 10.1007/978-3-319-24574-4_28.
[2] A. Cardona, S. Saalfeld, S. Preibisch, B. Schmid, A. Cheng, J. Pulokas, P. Tomancak, and V. Hartenstein, “An Integrated Micro- and Macroarchitectural Analysis of the Drosophila Brain by Computer-Assisted Serial Section Electron Microscopy,” PLoS Biology, vol. 8, no. 10, Art. no. e1000502, Oct. 2010, doi: 10.1371/journal.pbio.1000502. :contentReference[oaicite:9]{index=9}
[3] F. Milletari, N. Navab, and S.-A. Ahmadi, “V-Net: Fully Convolutional Neural Networks for Volumetric Medical Image Segmentation,” in Proc. 4th International Conference on 3D Vision (3DV), Stanford, CA, USA, 2016, pp. 565–571, doi: 10.1109/3DV.2016.79. :contentReference[oaicite:10]{index=10}
[4] S. S. M. Salehi, D. Erdogmus, and A. Gholipour, “Tversky Loss Function for Image Segmentation Using 3D Fully Convolutional Deep Networks,” in Machine Learning in Medical Imaging, Lecture Notes in Computer Science, vol. 10541, 2017, pp. 379–387.
[5] V. Jain et al., “Boundary Learning by Optimization with Topological Constraints,” in Proc. IEEE Computer Society Conference on Computer Vision and Pattern Recognition (CVPR), San Francisco, CA, USA, 2010, pp. 2488–2495, doi: 10.1109/CVPR.2010.5539950. :contentReference[oaicite:11]{index=11}
Nội dung gốc thuộc tác giả. Vui lòng không đăng lại toàn văn khi chưa được phép, trừ trường hợp pháp luật hoặc giấy phép áp dụng cho phép. Nội dung của bên thứ ba tuân theo quyền và giấy phép tương ứng.