Kolmogorov-Arnold Network (KAN) mở ra một hướng khác với MLP truyền thống: thay vì chỉ học các trọng số vô hướng trên mỗi kết nối, KAN có thể học những hàm phi tuyến một biến trên các cạnh. Khi đưa ý tưởng này vào kiến trúc encoder-decoder như U-Net, ta có thể sử dụng convolution để giữ cấu trúc không gian của ảnh MRI và dùng KAN để thực hiện các phép biến đổi phi tuyến mạnh hơn trên representation trung gian.
Một bài toán phù hợp để nghiên cứu hướng này là phân đoạn u thần kinh đệm trên BraTS 2020. Dataset cung cấp MRI đa mô thức và yêu cầu xác định các vùng Whole Tumor (WT), Tumor Core (TC) và Enhancing Tumor (ET). Đây là bài toán 3D có sự mất cân bằng voxel lớn, hình dạng khối u rất đa dạng và ranh giới giữa các mô bệnh lý không đơn giản.
- BraTS 2020 sử dụng bốn MRI: T1, T1Gd/T1ce, T2 và FLAIR.
- Các nhãn gốc 1, 2 và 4 được tổng hợp thành ba vùng đánh giá WT, TC và ET.
- Một hướng thực tế là giữ encoder-decoder 3D convolution và đặt KAN ở bottleneck, nơi feature map đã nhỏ hơn.
- Loss có thể kết hợp Dice Loss và BCEWithLogitsLoss cho ba mask WT/TC/ET.
- KAN không tự động đảm bảo Dice cao hơn U-Net; cần benchmark công bằng với U-Net, nnU-Net hoặc các baseline 3D khác.
BraTS 2020: bài toán thực tế mà mô hình phải giải quyết
BraTS 2020 tập trung vào phân đoạn glioma từ MRI đa tham số. Dữ liệu được thu nhận từ nhiều cơ sở và máy quét khác nhau. Theo mô tả chính thức của BraTS, ảnh đã được đồng đăng ký về cùng không gian giải phẫu, nội suy về độ phân giải voxel 1 mm³ và skull-stripping trước khi cung cấp cho người tham gia.
Mỗi trường hợp gồm bốn chuỗi MRI:
| Modality | Ý nghĩa trực quan trong bài toán |
|---|---|
| T1 | Cung cấp cấu trúc giải phẫu T1-weighted cơ bản. |
| T1Gd / T1ce | MRI T1 sau tiêm chất tương phản; rất quan trọng đối với vùng enhancing tumor. |
| T2 | Cung cấp thông tin khác biệt về mô và vùng có hàm lượng dịch cao. |
| FLAIR | Đặc biệt hữu ích để quan sát vùng phù/infiltration xung quanh khối u. |
Training cohort BraTS 2020 có 369 trường hợp. Validation cohort gồm 125 trường hợp và test cohort gồm 166 trường hợp; ground truth của validation và test không được phát trực tiếp cho người tham gia như training set.
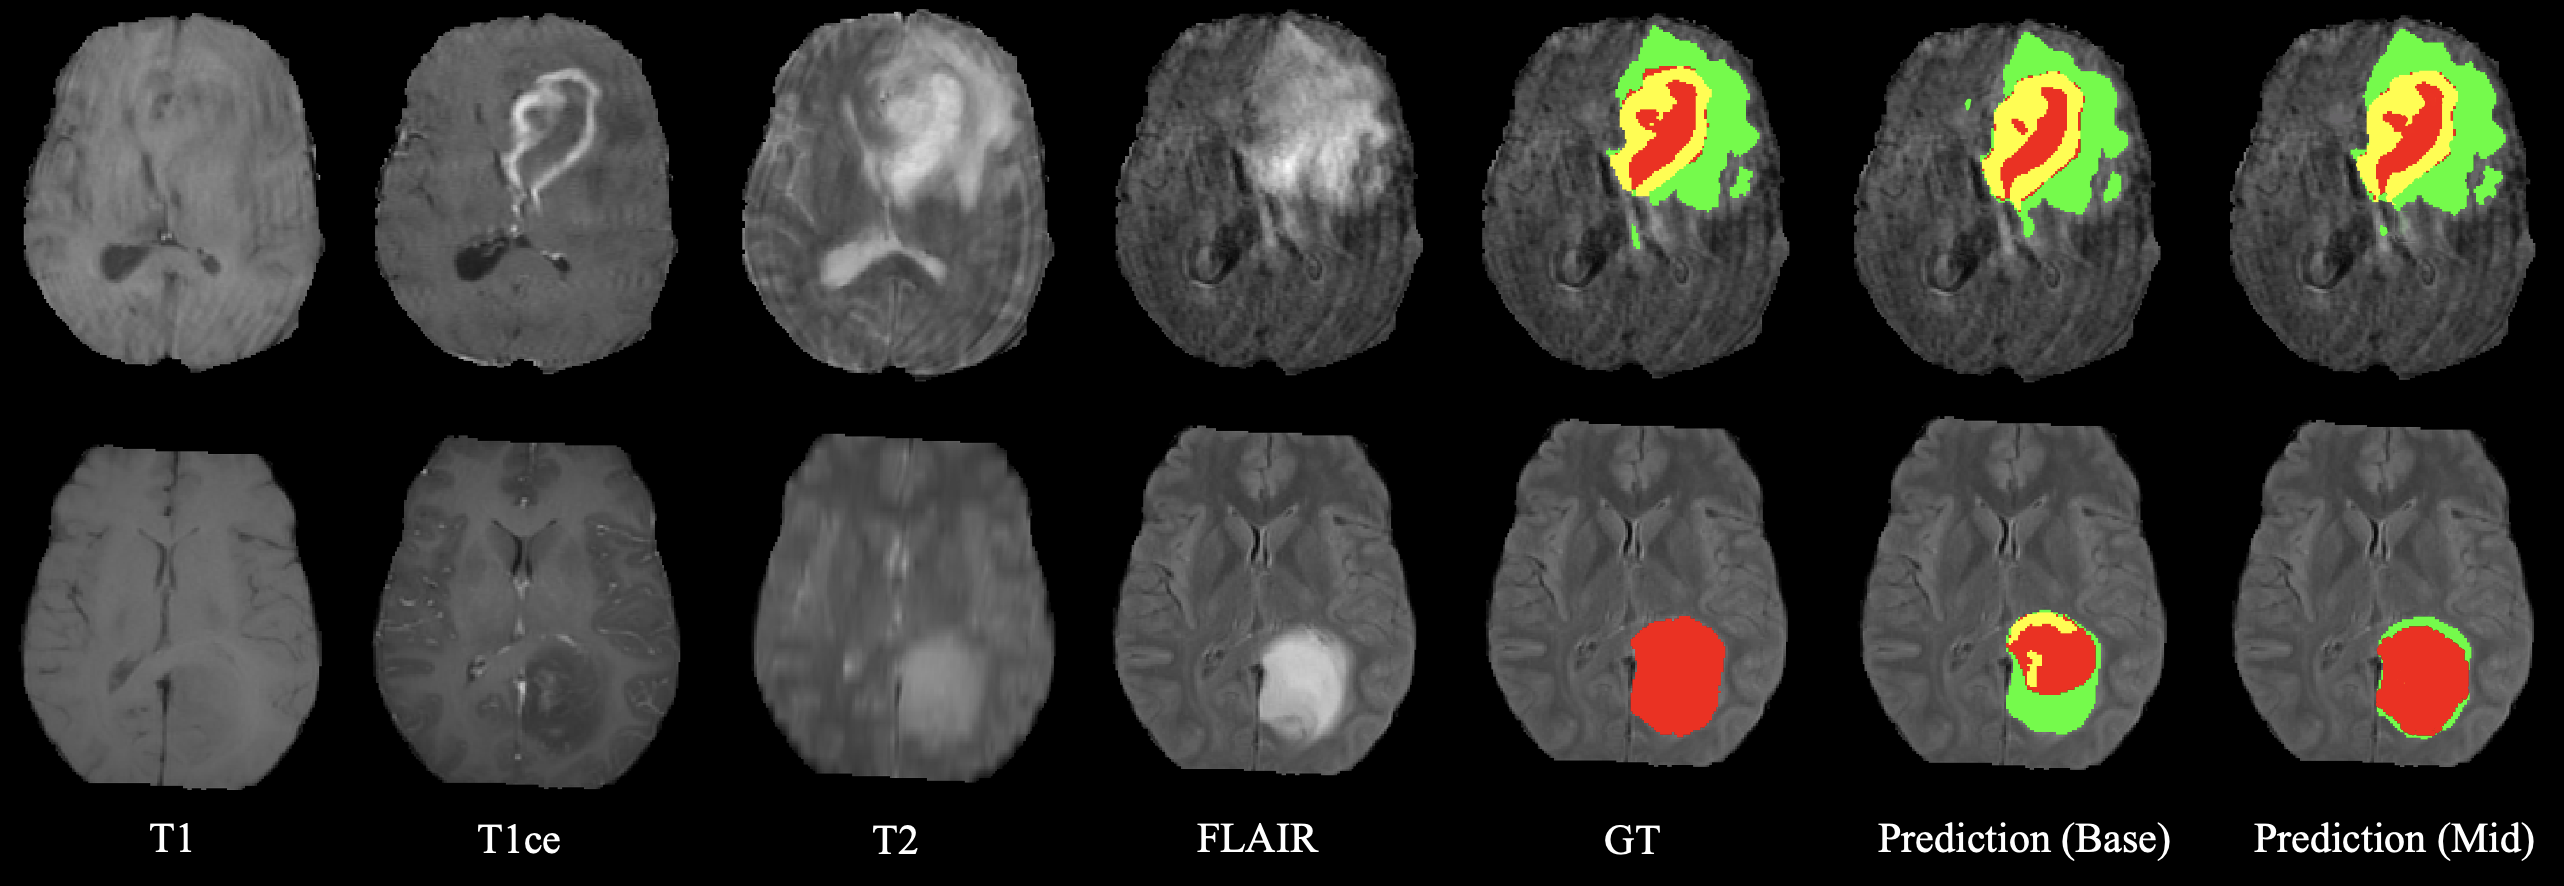
Hình trên rất hữu ích để thấy tại sao cần MRI đa mô thức. Cùng một khối u nhưng độ tương phản và hình dạng quan sát được thay đổi đáng kể giữa T1, T1ce, T2 và FLAIR. Một mô hình chỉ xử lý một modality sẽ mất một phần thông tin mà những modality khác cung cấp.
Nhãn voxel của BraTS 2020
Ground truth gốc sử dụng các giá trị:
| Label | Vùng |
|---|---|
| 0 | Background / mô khác |
| 1 | Necrotic and non-enhancing tumor core — NCR/NET |
| 2 | Peritumoral edema — ED |
| 4 | GD-enhancing tumor — ET |
BraTS đánh giá ba vùng tổng hợp thay vì chỉ đánh giá từng label độc lập:
Quan hệ này cũng cho thấy cấu trúc phân cấp tự nhiên:
Tại sao đưa KAN vào kiến trúc phân đoạn u não?
Trong một layer fully connected thông thường, mỗi kết nối chủ yếu được đặc trưng bởi một trọng số. KAN thay cách tham số hóa này bằng một hàm một biến có thể học được trên mỗi kết nối.
Với phân đoạn MRI, ý tưởng hấp dẫn là cho KAN học các quan hệ phi tuyến giữa các channel đặc trưng tại bottleneck. Những channel này đã không còn là cường độ MRI thô mà là representation được encoder trích xuất từ nhiều modality và nhiều vùng không gian.
U-KAN đã đưa ý tưởng này vào U-Net bằng cách token hóa feature map trung gian rồi xử lý chúng bằng các KAN layer. Encoder và decoder convolution vẫn đảm nhiệm locality, downsampling, upsampling và skip connection; KAN được đặt trong phần representation sâu hơn.

Một nghiên cứu tiếp theo đã chuyển U-KAN từ 2D sang 3D multi-modal MRI brain tumor segmentation và xây dựng thêm biến thể UKAN-SE. Công trình đó sử dụng BraTS 2024, không phải BraTS 2020. Điều này vẫn là bằng chứng kỹ thuật quan trọng rằng ý tưởng U-KAN có thể được mở rộng sang tensor MRI 3D.
Thiết kế KAN-U-Net 3D cho BraTS 2020
Một thiết kế hợp lý cho BraTS 2020 có thể nhận tensor:
Bốn channel lần lượt tương ứng T1, T1ce, T2 và FLAIR. Model tạo ba logit volume cho WT, TC và ET.
T1 / T1ce / T2 / FLAIR
Conv + downsample
Bottleneck
Up + skip
WT / TC / ET
Tại sao KAN nên đặt ở bottleneck?
Một MRI 3D chứa rất nhiều voxel. Nếu KAN được áp dụng trực tiếp trên feature map độ phân giải cao, số token và bộ nhớ trung gian có thể trở nên rất lớn. Sau ba lần downsampling, số vị trí không gian giảm đáng kể, trong khi mỗi token đã chứa representation giàu ngữ nghĩa hơn.
Ví dụ, nếu patch đầu vào có kích thước 128 × 128 × 128 thì sau ba lần giảm một nửa mỗi chiều, bottleneck chỉ còn:
Đây vẫn là một lượng token đáng kể nhưng khả thi hơn rất nhiều so với áp dụng KAN tại full resolution.
Skip connection vẫn rất quan trọng
Khối u có thể chứa vùng ET rất nhỏ. Nếu encoder chỉ truyền bottleneck cuối cùng cho decoder, thông tin biên và chi tiết ở độ phân giải cao dễ bị mất. Skip connection giúp decoder nhận lại feature map từ các stage nông hơn.
Do đó KAN nên bổ sung khả năng biến đổi representation, chứ không nên loại bỏ cơ chế multi-scale của U-Net.
Tiền xử lý, target và loss cho BraTS 2020
Chuẩn hóa từng modality
Mặc dù BraTS đã thực hiện nhiều bước preprocessing, cường độ MRI không có thang tuyệt đối giống CT. Một pipeline thường chuẩn hóa từng modality trên các voxel thuộc vùng não.
Mean và standard deviation nên được tính riêng cho từng MRI channel, thường chỉ trên các voxel khác 0 để vùng padding/background không làm sai thống kê.
Chuyển label map thành WT, TC và ET
import torch


def brats_regions(label):
    """
    label: Tensor [B, D, H, W]
    BraTS labels: 0, 1, 2, 4

    Output:
        [B, 3, D, H, W]
        channel 0 = WT
        channel 1 = TC
        channel 2 = ET
    """

    wt = (
        (label == 1)
        | (label == 2)
        | (label == 4)
    ).float()

    tc = (
        (label == 1)
        | (label == 4)
    ).float()

    et = (
        label == 4
    ).float()

    return torch.stack(
        [wt, tc, et],
        dim=1
    )
Ba channel này là multi-label masks chứ không phải ba class loại trừ lẫn nhau. Một voxel ET đồng thời thuộc TC và WT. Vì vậy dùng Sigmoid độc lập trên ba output là phù hợp với cách biểu diễn này.
Dice Loss
Tumor voxel ít hơn background rất nhiều, nên chỉ sử dụng accuracy hoặc BCE có thể khiến optimization thiên về background. Dice trực tiếp đo mức độ overlap:
Với xác suất mềm, có thể dùng:
Kết hợp BCE và Dice
Một baseline đơn giản có thể bắt đầu với λD = λB = 1, sau đó điều chỉnh bằng validation set. Không nên chọn trọng số chỉ vì ET nhỏ hơn; cần kiểm tra metric của từng vùng.
import torch
import torch.nn as nn


def soft_dice_loss(
    logits,
    targets,
    eps=1e-5
):
    probs = torch.sigmoid(logits)

    dims = (
        0,
        2,
        3,
        4
    )

    intersection = (
        probs * targets
    ).sum(dims)

    denominator = (
        probs.sum(dims)
        + targets.sum(dims)
    )

    dice = (
        2.0 * intersection + eps
    ) / (
        denominator + eps
    )

    return 1.0 - dice.mean()


bce_loss = nn.BCEWithLogitsLoss()


def segmentation_loss(
    logits,
    targets
):
    bce = bce_loss(
        logits,
        targets
    )

    dice = soft_dice_loss(
        logits,
        targets
    )

    return bce + dice
Code PyTorch: một KAN-U-Net 3D có thể chạy được
Để giữ code đủ ngắn cho mục đích học tập nhưng vẫn có thể chạy độc lập, ví dụ dưới đây sử dụng một RBF-KAN layer: hàm trên cạnh được biểu diễn bởi nhiều radial basis function. Đây là một cách tham số hóa KAN hiệu quả và dễ triển khai, nhưng không phải B-spline KAN nguyên bản của pykan. Nếu mục tiêu là tái lập chính xác U-KAN paper, cần dùng implementation chính thức của công trình đó.
import torch
import torch.nn as nn
import torch.nn.functional as F


class ConvBlock3D(nn.Module):

    def __init__(
        self,
        in_channels,
        out_channels
    ):
        super().__init__()

        self.block = nn.Sequential(
            nn.Conv3d(
                in_channels,
                out_channels,
                kernel_size=3,
                padding=1,
                bias=False
            ),
            nn.InstanceNorm3d(
                out_channels,
                affine=True
            ),
            nn.GELU(),

            nn.Conv3d(
                out_channels,
                out_channels,
                kernel_size=3,
                padding=1,
                bias=False
            ),
            nn.InstanceNorm3d(
                out_channels,
                affine=True
            ),
            nn.GELU()
        )

    def forward(self, x):
        return self.block(x)


class RBFKANLayer(nn.Module):
    """
    KAN-inspired layer dùng Gaussian RBF basis.

    Input:
        [..., in_features]

    Output:
        [..., out_features]
    """

    def __init__(
        self,
        in_features,
        out_features,
        num_basis=8,
        grid_min=-2.0,
        grid_max=2.0
    ):
        super().__init__()

        centers = torch.linspace(
            grid_min,
            grid_max,
            num_basis
        ).repeat(
            in_features,
            1
        )

        self.register_buffer(
            "centers",
            centers
        )

        spacing = (
            grid_max - grid_min
        ) / max(
            num_basis - 1,
            1
        )

        self.gamma = (
            1.0
            / (spacing ** 2)
        )

        self.spline_weight = nn.Parameter(
            torch.empty(
                out_features,
                in_features,
                num_basis
            )
        )

        nn.init.xavier_uniform_(
            self.spline_weight
        )

        self.base = nn.Linear(
            in_features,
            out_features
        )

    def forward(self, x):

        diff = (
            x.unsqueeze(-1)
            - self.centers
        )

        basis = torch.exp(
            -self.gamma * diff.pow(2)
        )

        nonlinear = torch.einsum(
            "...ig,oig->...o",
            basis,
            self.spline_weight
        )

        base = self.base(
            F.silu(x)
        )

        return base + nonlinear


class TokenKAN3D(nn.Module):
    """
    Chuyển mỗi voxel ở bottleneck thành một token.
    KAN hoạt động trên chiều channel.
    """

    def __init__(
        self,
        channels,
        num_basis=8
    ):
        super().__init__()

        self.norm = nn.LayerNorm(
            channels
        )

        self.kan1 = RBFKANLayer(
            channels,
            channels,
            num_basis
        )

        self.kan2 = RBFKANLayer(
            channels,
            channels,
            num_basis
        )

        self.dwconv = nn.Conv3d(
            channels,
            channels,
            kernel_size=3,
            padding=1,
            groups=channels,
            bias=False
        )

    def forward(self, x):

        residual = x

        # B,C,D,H,W → B,D,H,W,C
        x = x.permute(
            0,
            2,
            3,
            4,
            1
        ).contiguous()

        x = self.norm(x)

        x = self.kan1(x)
        x = self.kan2(x)

        # B,D,H,W,C → B,C,D,H,W
        x = x.permute(
            0,
            4,
            1,
            2,
            3
        ).contiguous()

        x = self.dwconv(x)

        return residual + x


class KANUNet3D(nn.Module):

    def __init__(
        self,
        in_channels=4,
        out_channels=3
    ):
        super().__init__()

        self.pool = nn.MaxPool3d(2)

        self.enc1 = ConvBlock3D(
            in_channels,
            32
        )

        self.enc2 = ConvBlock3D(
            32,
            64
        )

        self.enc3 = ConvBlock3D(
            64,
            128
        )

        self.bottleneck = ConvBlock3D(
            128,
            256
        )

        self.kan = TokenKAN3D(
            channels=256,
            num_basis=8
        )

        self.up3 = nn.ConvTranspose3d(
            256,
            128,
            kernel_size=2,
            stride=2
        )

        self.dec3 = ConvBlock3D(
            256,
            128
        )

        self.up2 = nn.ConvTranspose3d(
            128,
            64,
            kernel_size=2,
            stride=2
        )

        self.dec2 = ConvBlock3D(
            128,
            64
        )

        self.up1 = nn.ConvTranspose3d(
            64,
            32,
            kernel_size=2,
            stride=2
        )

        self.dec1 = ConvBlock3D(
            64,
            32
        )

        self.head = nn.Conv3d(
            32,
            out_channels,
            kernel_size=1
        )

    def forward(self, x):

        e1 = self.enc1(x)

        e2 = self.enc2(
            self.pool(e1)
        )

        e3 = self.enc3(
            self.pool(e2)
        )

        b = self.bottleneck(
            self.pool(e3)
        )

        b = self.kan(b)

        d3 = self.up3(b)

        d3 = self.dec3(
            torch.cat(
                [d3, e3],
                dim=1
            )
        )

        d2 = self.up2(d3)

        d2 = self.dec2(
            torch.cat(
                [d2, e2],
                dim=1
            )
        )

        d1 = self.up1(d2)

        d1 = self.dec1(
            torch.cat(
                [d1, e1],
                dim=1
            )
        )

        return self.head(d1)


# Kiểm tra shape
model = KANUNet3D()

x = torch.randn(
    1,
    4,
    32,
    32,
    32
)

logits = model(x)

print(logits.shape)

# torch.Size([1, 3, 32, 32, 32])
Code trên giữ toàn bộ spatial structure 3D. Ba output channel là raw logits WT, TC và ET. Sigmoid không được đặt trực tiếp trong model vì BCEWithLogitsLoss cần nhận logits để có tính ổn định số học tốt hơn.
Trong thí nghiệm thực tế với patch lớn hơn, memory consumption sẽ tăng nhanh. Mixed precision, patch-based training và gradient accumulation thường cần được cân nhắc.
Training step
device = torch.device(
    "cuda"
    if torch.cuda.is_available()
    else "cpu"
)

model = KANUNet3D().to(device)

optimizer = torch.optim.AdamW(
    model.parameters(),
    lr=1e-4,
    weight_decay=1e-5
)

model.train()

for images, labels in train_loader:

    images = images.to(device)

    labels = labels.to(device)

    targets = brats_regions(
        labels
    )

    optimizer.zero_grad()

    logits = model(images)

    loss = segmentation_loss(
        logits,
        targets
    )

    loss.backward()

    optimizer.step()
Đánh giá mô hình KAN trên BraTS 2020 như thế nào?
BraTS không chỉ quan tâm tới voxel accuracy. Theo framework chính thức của challenge, các metric quan trọng của segmentation gồm Dice và Hausdorff Distance 95% cùng với sensitivity và specificity.
Dice Score
Dice càng gần 1 thì overlap giữa prediction và ground truth càng lớn. Cần báo cáo riêng:
- Dice WT
- Dice TC
- Dice ET
Không nên chỉ lấy trung bình rồi bỏ qua từng vùng. ET thường nhỏ và khó hơn WT; một model có mean Dice tốt vẫn có thể thất bại nghiêm trọng ở ET.
Hausdorff Distance 95%
Dice đo overlap nhưng không phản ánh hoàn toàn sai lệch biên. HD95 đo khoảng cách biên theo percentile 95, giúp giảm ảnh hưởng của một số outlier cực đoan so với Hausdorff Distance cực đại.
Trong segmentation y tế, hai mask có Dice tương đương vẫn có thể khác nhau đáng kể về HD95 nếu một mask có vùng false positive nằm xa khối u thật.
Thiết kế thí nghiệm công bằng
Nếu mục tiêu là kiểm tra KAN thực sự có ích hay không, cần giữ các yếu tố còn lại gần như giống nhau:
| Model | Bottleneck | Mục đích |
|---|---|---|
| 3D U-Net | Conv block | Baseline |
| 3D U-Net + MLP | Token MLP | Kiểm tra lợi ích do tokenization |
| 3D KAN-U-Net | Token KAN | Kiểm tra chính KAN |
Ba model cần được huấn luyện với cùng train/validation split, augmentation, patch size, optimizer, learning-rate schedule và số epoch. Nếu KAN dùng nhiều parameter hơn đáng kể, cần báo cáo cả parameter count và memory thay vì chỉ so Dice.
Kiểm tra tính phân cấp của prediction
Nếu model dự đoán WT, TC và ET bằng ba Sigmoid độc lập, có thể xuất hiện trường hợp ET được dự đoán tại voxel nhưng TC hoặc WT lại bằng 0, vi phạm quan hệ ET ⊆ TC ⊆ WT.
Một post-processing đơn giản có thể ép consistency:
probs = torch.sigmoid(logits)

pred = (
    probs >= 0.5
)

wt = pred[:, 0]
tc = pred[:, 1]
et = pred[:, 2]

# ET phải thuộc TC
tc = tc | et

# TC phải thuộc WT
wt = wt | tc
Đây chỉ là baseline post-processing. Một hướng chặt chẽ hơn là thiết kế hierarchical loss hoặc parameterization bảo đảm nesting ngay trong model.
Kết luận
BraTS 2020 là một ví dụ rất phù hợp để nghiên cứu KAN trong medical image segmentation vì bài toán đòi hỏi xử lý đồng thời bốn MRI modality, representation 3D, mất cân bằng voxel và ba vùng u có quan hệ phân cấp. Một thiết kế thực tế không cần loại bỏ CNN: encoder-decoder 3D vẫn xử lý locality và multi-scale features, trong khi KAN được đặt tại bottleneck để học các phép biến đổi phi tuyến trên latent channels.
Điểm quan trọng nhất về mặt nghiên cứu là tách biệt ý tưởng có cơ sở với kết quả đã được chứng minh. U-KAN đã cho thấy KAN có thể kết hợp với U-Net trong phân đoạn y tế, và 3D U-KAN đã chứng minh khả năng mở rộng sang MRI u não đa mô thức; nhưng hiệu quả cụ thể trên BraTS 2020 phải được xác nhận bằng thí nghiệm riêng với Dice WT/TC/ET, HD95, số tham số, GPU memory và thời gian huấn luyện.
References
- B. H. Menze et al., “The multimodal brain tumor image segmentation benchmark (BRATS),” IEEE Transactions on Medical Imaging, vol. 34, no. 10, pp. 1993–2024, Oct. 2015, doi: 10.1109/TMI.2014.2377694.
- S. Bakas et al., “Advancing The Cancer Genome Atlas glioma MRI collections with expert segmentation labels and radiomic features,” Scientific Data, vol. 4, Art. no. 170117, Sep. 2017, doi: 10.1038/sdata.2017.117.
- S. Bakas et al., “Identifying the best machine learning algorithms for brain tumor segmentation, progression assessment, and overall survival prediction in the BRATS challenge,” arXiv preprint arXiv:1811.02629, 2018.
- R. Mehta et al., “QU-BraTS: MICCAI BraTS 2020 challenge on quantifying uncertainty in brain tumor segmentation—Analysis of ranking scores and benchmarking results,” Machine Learning for Biomedical Imaging, vol. 1, pp. 1–54, Aug. 2022, doi: 10.59275/j.melba.2022-354b.
- Z. Liu et al., “KAN: Kolmogorov-Arnold Networks,” arXiv preprint arXiv:2404.19756, 2024.
- C. Li, X. Liu, W. Li, C. Wang, H. Liu, Y. Liu, Z. Chen, and Y. Yuan, “U-KAN makes strong backbone for medical image segmentation and generation,” in Proc. AAAI Conf. Artificial Intelligence, vol. 39, no. 5, 2025, pp. 4652–4660, doi: 10.1609/aaai.v39i5.32491.
- T. Tang, Y. Chen, and H. Shu, “3D U-KAN implementation for multi-modal MRI brain tumor segmentation,” arXiv preprint arXiv:2408.00273, 2024.
- H. Li, Y. Nan, J. Del Ser, and G. Yang, “Large-kernel attention for 3D medical image segmentation,” Cognitive Computation, vol. 16, pp. 2063–2077, 2024, doi: 10.1007/s12559-023-10126-7.
- Center for Biomedical Image Computing and Analytics, University of Pennsylvania, “Multimodal Brain Tumor Segmentation Challenge 2020: Data,” BraTS 2020. [Online]. Available: https://www.med.upenn.edu/cbica/brats2020/data.html.
- Center for Biomedical Image Computing and Analytics, University of Pennsylvania, “Multimodal Brain Tumor Segmentation Challenge 2020: Tasks and evaluation framework,” BraTS 2020. [Online]. Available: https://www.med.upenn.edu/cbica/brats2020/tasks.html.
Nội dung gốc thuộc tác giả. Vui lòng không đăng lại toàn văn khi chưa được phép, trừ trường hợp pháp luật hoặc giấy phép áp dụng cho phép. Nội dung của bên thứ ba tuân theo quyền và giấy phép tương ứng.