Chuỗi U-Net — Bài 2. Hiểu sơ đồ chữ U là chưa đủ để tự xây dựng U-Net chính xác. Phần dễ sai nhất nằm ở kích thước tensor: convolution làm thay đổi feature map thế nào, pooling giảm kích thước ra sao, decoder tăng độ phân giải bằng cách nào và tại sao hai tensor trong skip connection đôi khi không thể concatenate trực tiếp.
Bài này phân tích U-Net ở mức tensor. Mục tiêu là có thể nhìn vào một cấu hình convolution, pooling hoặc transposed convolution và tính được chính xác shape đầu ra trước khi chạy mô hình.
- Kích thước đầu ra của convolution được quyết định bởi kernel, stride, padding và dilation.
- Max pooling trong encoder giảm độ phân giải không gian, còn decoder phải phục hồi kích thước trước khi ghép với feature map từ encoder.
- Transposed convolution không phải phép nghịch đảo của convolution; nó là phép biến đổi học được dùng để tăng độ phân giải feature map.
- U-Net gốc sử dụng convolution không padding nên cần crop feature map ở skip connection; nhiều U-Net hiện đại dùng padding để đơn giản hóa việc căn chỉnh tensor.
1. Shape là phần quan trọng của kiến trúc U-Net
Một tensor ảnh trong PyTorch thường có dạng N × C × H × W, trong đó N là batch size, C là số kênh, H là chiều cao và W là chiều rộng. Với một ảnh RGB 256×256, tensor của một ảnh có thể có shape 1 × 3 × 256 × 256.
Trong encoder của U-Net, H và W giảm dần trong khi C thường tăng. Decoder thực hiện quá trình ngược lại: độ phân giải không gian tăng dần và số kênh giảm. Kiến trúc gốc của Ronneberger, Fischer và Brox sử dụng một contracting path để thu nhận ngữ cảnh và một expanding path để phục hồi vị trí chính xác [1]. :contentReference[oaicite:0]{index=0}
Điểm cần chú ý là sơ đồ trên minh họa một phiên bản hiện đại dùng padding để giữ kích thước sau convolution. U-Net gốc không hoạt động như vậy. Paper năm 2015 sử dụng convolution 3×3 không padding, vì thế kích thước giảm ngay cả khi stride bằng 1 [1].
2. Tính kích thước sau convolution và pooling
Cho kích thước đầu vào theo một chiều là i, kernel size k, padding p, stride s và dilation d. Kích thước đầu ra của convolution được tính bởi:
Quan hệ giữa input size, kernel, padding, stride và output size là phần cơ bản của convolution arithmetic và được hệ thống hóa rõ trong tài liệu của Dumoulin và Visin [2]. :contentReference[oaicite:1]{index=1}
Trường hợp 1: convolution 3×3 không padding
Với k=3, s=1, p=0, d=1, công thức trở thành:
Do đó feature map 572×572 sau một convolution 3×3 trở thành 570×570. Sau convolution thứ hai, kích thước còn 568×568. Đây chính là những con số xuất hiện ở tầng đầu tiên của U-Net gốc.
Trường hợp 2: convolution 3×3 với same padding
Nếu đặt p=1 cùng kernel 3×3 và stride 1:
Đây là cấu hình phổ biến trong các implementation U-Net hiện đại: convolution thay đổi nội dung và số channel nhưng không thay đổi H×W.
Max pooling 2×2
Trong U-Net gốc, mỗi mức encoder kết thúc bằng max pooling 2×2 với stride 2. Với đầu vào có kích thước chia hết cho 2:
Ví dụ, 568×568 trở thành 284×284. Sau bốn bước pooling, độ phân giải giảm rất mạnh nhưng receptive field của các neuron ở tầng sâu bao phủ vùng ngày càng lớn trên ảnh ban đầu.
3. Transposed convolution thực sự làm gì?
Decoder cần chuyển feature map nhỏ thành feature map lớn hơn. U-Net gốc thực hiện điều này bằng một phép upsampling theo sau bởi convolution 2×2, thường được gọi trong paper là up-convolution [1]. Các implementation hiện đại thường hiện thực bước này bằng transposed convolution hoặc bằng interpolation kết hợp convolution.
Transposed convolution không phải phép nghịch đảo của convolution. Nó được gọi là “transposed” vì phép toán có thể được biểu diễn bằng ma trận chuyển vị của toán tử convolution tương ứng; nó không thể tự động khôi phục thông tin đã mất sau pooling hoặc convolution giảm mẫu [2].
Với input size i, stride s, padding p, dilation d, kernel k và output padding q, kích thước của transposed convolution theo một chiều có thể viết:
Xét cấu hình thường gặp trong U-Net hiện đại:
kernel = 2
stride = 2
padding = 0
output_padding = 0
Khi đó:
Feature map 32×32 vì thế trở thành 64×64. Đây là cấu hình thuận tiện để decoder tăng gấp đôi độ phân giải ở mỗi mức.
| Phương pháp | Có tham số học? | Vai trò |
|---|---|---|
| Nearest-neighbor interpolation | Không | Phóng to feature map theo quy tắc cố định |
| Bilinear interpolation | Không | Nội suy trơn trước convolution |
| Transposed convolution | Có | Học phép biến đổi tăng độ phân giải |
Không có quy tắc rằng transposed convolution luôn tốt hơn interpolation. Hai lựa chọn có cơ chế khác nhau và cần được đánh giá trong bối cảnh dữ liệu, độ phức tạp mô hình và chất lượng segmentation thực tế.
4. Skip connection và bài toán concatenate tensor
Sau khi decoder tăng độ phân giải, U-Net lấy feature map từ encoder ở cùng mức và nối nó với tensor decoder theo chiều channel. Với PyTorch, phép toán thường có dạng:
Giả sử tensor decoder có shape:
và skip tensor từ encoder có shape:
Sau concatenate theo channel:
H và W phải bằng nhau. Channel không cần bằng nhau vì chính chiều này được nối lại. Nếu decoder có kích thước 64×64 nhưng skip feature là 65×65, phép concatenate trực tiếp sẽ thất bại.
Tại sao U-Net gốc phải crop?
Convolution 3×3 không padding của U-Net gốc làm feature map encoder nhỏ dần sau từng convolution. Vì vậy, khi một tensor từ encoder được chuyển ngang sang decoder, nó lớn hơn tensor decoder tương ứng. Paper sử dụng thao tác copy and crop trước khi concatenate [1]. Trang dự án chính thức của University of Freiburg cũng mô tả các khối màu trắng trong sơ đồ là các feature map được sao chép từ contracting path. :contentReference[oaicite:2]{index=2}
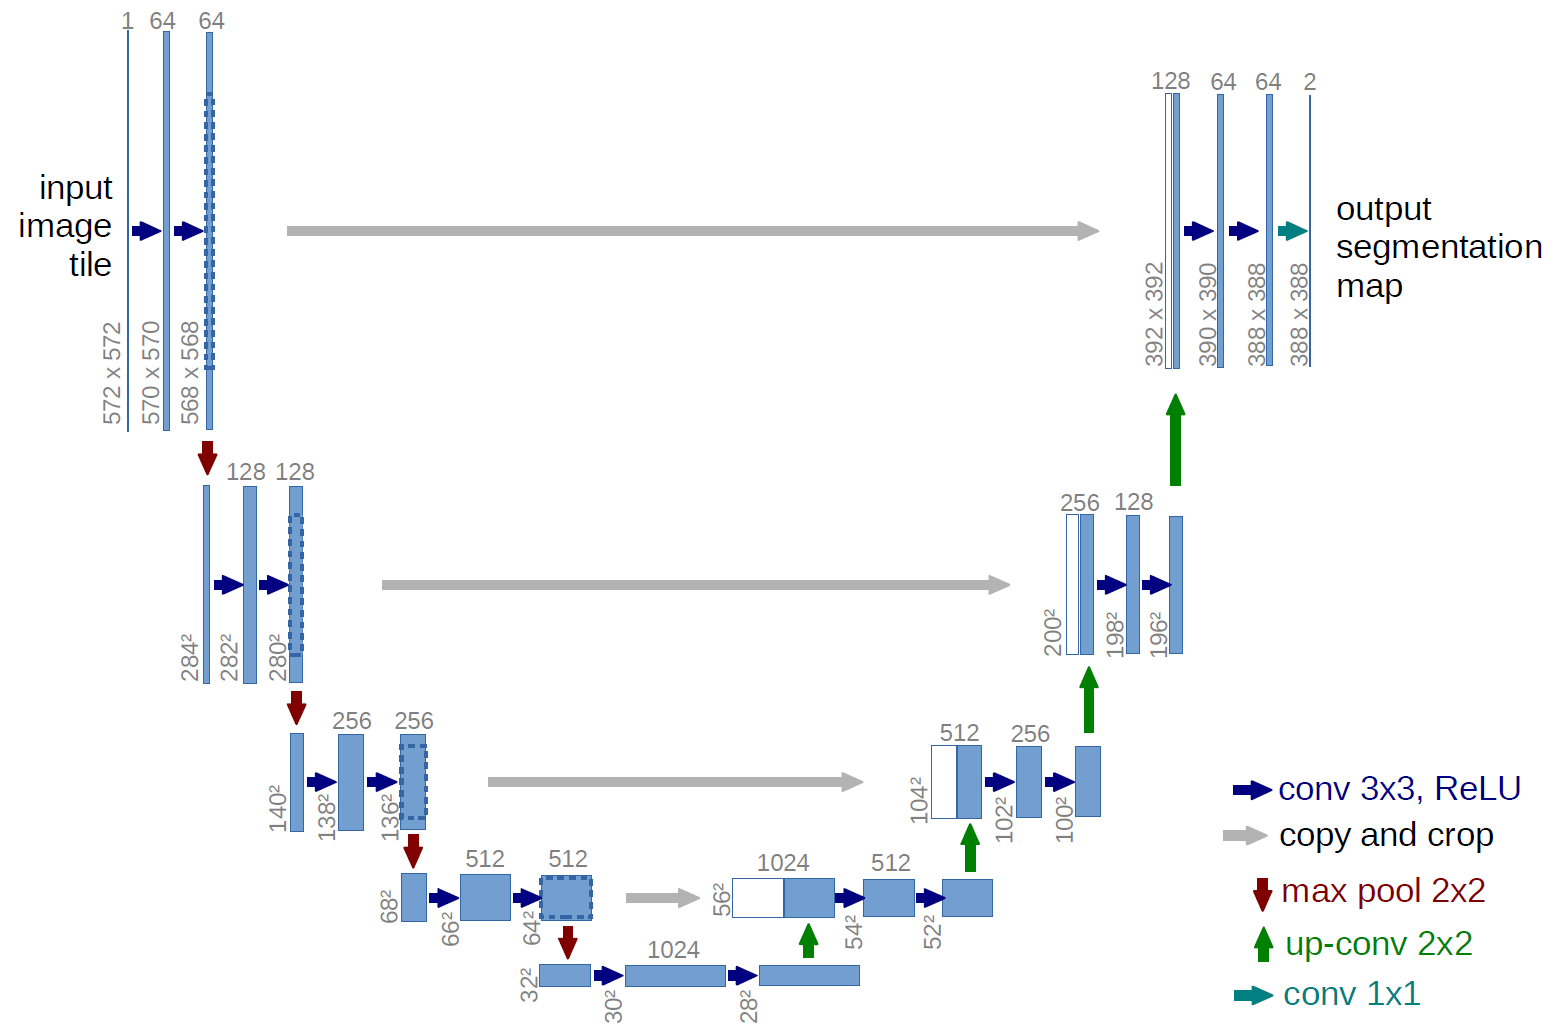
Sơ đồ này rất hữu ích vì nó cho thấy trực tiếp kích thước H×W tại từng bước. Input 572×572 không tạo output 572×572 mà cuối cùng tạo segmentation map 388×388.
Modern U-Net thường xử lý khác
Một implementation hiện đại thường đặt padding=1 cho convolution 3×3. Khi đó hai convolution trong mỗi block không làm H và W giảm, nên skip connection dễ căn chỉnh hơn.
Tuy nhiên, lỗi shape vẫn có thể xuất hiện nếu kích thước input không phù hợp với số lần pooling. Nếu encoder có L lần giảm kích thước theo hệ số 2, lựa chọn đơn giản nhất là H và W chia hết cho:
Ví dụ bốn lần pooling tương ứng hệ số 16. Các kích thước như 256×256 hoặc 512×512 thuận tiện vì chia hết cho 16. Đây không phải điều kiện toán học bắt buộc đối với mọi U-Net, nhưng giúp tránh sai lệch một pixel do phép chia nguyên khi downsampling.
5. Theo dấu chính xác U-Net gốc từ 572×572 đến 388×388
Có thể kiểm chứng sơ đồ paper chỉ bằng công thức convolution và pooling. Xét riêng kích thước không gian, bỏ qua số channel:
| Bước | Phép toán | Kích thước |
|---|---|---|
| Input | — | 572 |
| Encoder 1 | Conv 3×3, Conv 3×3 | 572 → 570 → 568 |
| Pool 1 | MaxPool 2×2 | 568 → 284 |
| Encoder 2 | 2 × Conv 3×3 | 284 → 282 → 280 |
| Pool 2 | MaxPool 2×2 | 280 → 140 |
| Encoder 3 | 2 × Conv 3×3 | 140 → 138 → 136 |
| Pool 3 | MaxPool 2×2 | 136 → 68 |
| Encoder 4 | 2 × Conv 3×3 | 68 → 66 → 64 |
| Pool 4 | MaxPool 2×2 | 64 → 32 |
| Bottleneck | 2 × Conv 3×3 | 32 → 30 → 28 |
| Decoder 4 | Up 2×2 + 2 × Conv 3×3 | 28 → 56 → 54 → 52 |
| Decoder 3 | Up 2×2 + 2 × Conv 3×3 | 52 → 104 → 102 → 100 |
| Decoder 2 | Up 2×2 + 2 × Conv 3×3 | 100 → 200 → 198 → 196 |
| Decoder 1 | Up 2×2 + 2 × Conv 3×3 | 196 → 392 → 390 → 388 |
| Output | Conv 1×1 | 388 |
Bảng trên cũng giải thích tại sao crop là bắt buộc trong kiến trúc gốc. Chẳng hạn, bước upsampling đầu tiên tạo tensor 56×56, trong khi feature encoder tương ứng có kích thước 64×64. Encoder feature phải được crop từ 64 xuống 56 trước khi nối.
6. Kiểm tra công thức bằng Python trước khi xây model
Một cách hiệu quả để tránh lỗi shape là viết hàm tính kích thước trước khi triển khai toàn bộ mạng. Đoạn mã sau hiện thực trực tiếp hai công thức convolution và transposed convolution.
Kết quả lần lượt là 284 và 64. Cách kiểm tra này đặc biệt hữu ích khi kernel, stride hoặc padding khác các cấu hình quen thuộc.
Kiểm tra trực tiếp tensor trong PyTorch
Khi model đã được xây dựng, có thể kiểm tra shape ngay trong forward pass thay vì suy đoán.
Một assert đơn giản trước concatenate thường giúp phát hiện lỗi sớm hơn nhiều so với việc để lỗi lan sang convolution tiếp theo.
7. Kết luận
Cấu trúc chữ U chỉ hoạt động khi kích thước tensor giữa encoder và decoder được kiểm soát chính xác. Convolution quyết định H×W bằng kernel, padding, stride và dilation; pooling giảm độ phân giải; transposed convolution hoặc interpolation phục hồi kích thước; skip connection yêu cầu hai nhánh phải tương thích về không gian trước khi concatenate.
U-Net gốc 572×572 → 388×388 là một ví dụ rất tốt để học convolution arithmetic vì mọi thay đổi kích thước đều có thể tính được. Khi chuyển sang U-Net dùng same padding, việc quản lý shape đơn giản hơn nhưng nguyên lý không thay đổi.
Bài tiếp theo trong chuỗi có thể chuyển từ hình học tensor sang phần quan trọng thứ hai của U-Net: receptive field, feature representation và tại sao encoder học được ngữ cảnh trong khi skip connection giữ thông tin định vị.
Tài liệu tham khảo
[1] O. Ronneberger, P. Fischer, and T. Brox, “U-Net: Convolutional Networks for Biomedical Image Segmentation,” in Medical Image Computing and Computer-Assisted Intervention – MICCAI 2015, Munich, Germany, 2015, Lecture Notes in Computer Science, vol. 9351, pp. 234–241, doi: 10.1007/978-3-319-24574-4_28. arXiv · Official U-Net Project
[2] V. Dumoulin and F. Visin, “A Guide to Convolution Arithmetic for Deep Learning,” arXiv preprint arXiv:1603.07285, 2016, revised 2018, doi: 10.48550/arXiv.1603.07285. Paper
[3] J. Long, E. Shelhamer, and T. Darrell, “Fully Convolutional Networks for Semantic Segmentation,” in Proc. IEEE Conference on Computer Vision and Pattern Recognition (CVPR), Boston, MA, USA, 2015, pp. 3431–3440, doi: 10.1109/CVPR.2015.7298965.
Nội dung gốc thuộc tác giả. Vui lòng không đăng lại toàn văn khi chưa được phép, trừ trường hợp pháp luật hoặc giấy phép áp dụng cho phép. Nội dung của bên thứ ba tuân theo quyền và giấy phép tương ứng.
Nguồn gốc: U-Net: Kích thước Tensor, Pooling và Skip Connection